


Banyak perusahaan mulai mengevaluasi penggunaan AI untuk membantu karyawan mencari informasi, merangkum dokumen, menganalisis data, atau menjalankan pekerjaan yang berulang. Namun, sebelum memilih solusi dan membangun proof of concept (PoC), ada satu pertanyaan yang perlu dijawab lebih dulu: apakah data yang dibutuhkan untuk menjalankan use case tersebut sudah siap digunakan?
Pertanyaan ini penting bagi CIO, CTO, CDO, dan Head of Data yang bertanggung jawab memastikan investasi teknologi bisa diterapkan pada proses bisnis nyata. Sistem AI dapat terlihat menjanjikan saat diuji dengan contoh sederhana, tetapi hasilnya akan sulit diandalkan ketika sumber datanya tidak lengkap, saling bertentangan, sudah usang, atau tidak memiliki konteks yang cukup.
Kesenjangan ini perlu mendapat perhatian manajemen. Dalam riset Accenture tentang AI-ready data yang melibatkan eksekutif dari 2.000 perusahaan di 15 negara dan sembilan industri, hanya 7% perusahaan yang dinilai telah mencapai tingkat kesiapan data untuk menskalakan AI tingkat lanjut. Angka ini menegaskan bahwa kesiapan data perlu dinilai sebagai kapabilitas bisnis yang berkelanjutan, jauh melampaui pekerjaan teknis sebelum implementasi.
Key Takeaways
- Kesiapan data perlu dinilai berdasarkan use case yang ingin dijalankan, bukan dari jumlah data yang dimiliki perusahaan.
- Tujuh aspek penting meliputi relevansi, kelengkapan, akurasi, konsistensi, kebaruan, format, konteks, dan keterhubungan data.
- Perusahaan tidak harus merapikan seluruh data sekaligus. Mulailah dari sumber yang paling berpengaruh terhadap proses prioritas.
- Penilaian data yang terstruktur membantu perusahaan menentukan apakah use case siap diuji atau membutuhkan perbaikan terlebih dahulu.
Mengapa Kesiapan Data Menentukan Hasil Implementasi AI?
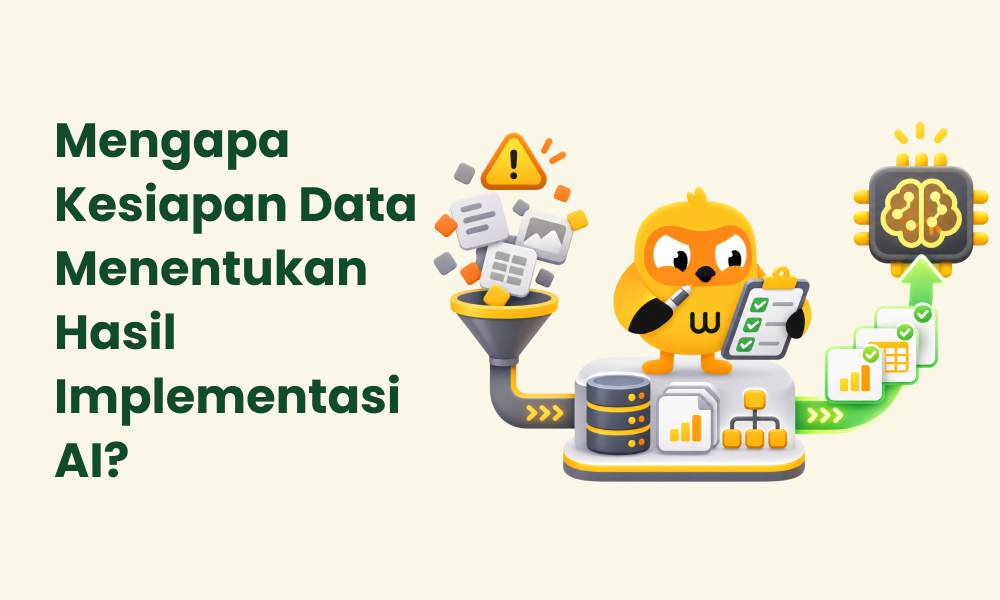
Dalam proyek analitik tradisional, data sering disiapkan untuk kebutuhan laporan, dashboard, atau analisis yang sudah ditentukan. Pengguna mengetahui tabel yang perlu dibuka, kolom yang perlu diperiksa, dan definisi angka yang digunakan. Ketika AI mulai menerima pertanyaan dalam bahasa sehari-hari atau diminta menyusun jawaban dari beberapa sumber, kebutuhan datanya menjadi lebih luas.
Sebuah jawaban dapat dipengaruhi oleh lebih dari satu sistem. Contohnya, pertanyaan mengenai status pesanan mungkin membutuhkan data transaksi, informasi pengiriman, catatan layanan pelanggan, dan kebijakan retur. Jika setiap sumber menggunakan kode, definisi, atau periode pembaruan yang berbeda, AI akan kesulitan menyatukan konteksnya.
Riset Accenture tentang data untuk AI tingkat lanjut menyoroti masalah data yang terisolasi, berkualitas rendah, dan kehilangan konteks bisnis sebagai penghambat penerapan dalam skala besar. Artinya, data yang tersedia belum tentu otomatis dapat digunakan. Perusahaan perlu memastikan bahwa sumber informasi relevan, dapat dipahami, dan cukup konsisten untuk menjawab kebutuhan tertentu.
Karena kesiapan tidak cukup dinilai dari keberadaan database, pemeriksaan perlu dimulai dari kebutuhan proses yang akan didukung AI.
7 Hal yang Perlu Diperiksa dalam Menilai Kesiapan Data untuk AI
Gunakan tujuh pemeriksaan berikut sebagai daftar awal. Setiap poin sebaiknya dinilai terhadap satu use case yang spesifik, sehingga tim tidak terjebak melakukan inventarisasi data tanpa mengetahui tujuan akhirnya.
- Relevansi data terhadap kebutuhan bisnis. Identifikasi pertanyaan atau aktivitas yang akan dibantu AI. Pastikan sumber yang tersedia benar-benar memuat informasi untuk menjawabnya. Jika use case membutuhkan histori keluhan pelanggan, misalnya, data transaksi saja belum mencukupi.
- Kelengkapan cakupan data. Periksa apakah periode, unit bisnis, cabang, produk, atau tahapan proses yang dibutuhkan sudah tercakup. Data yang hanya berisi sebagian periode dapat menghasilkan gambaran yang tidak utuh. Catat pula kolom penting yang sering kosong dan dokumen yang belum masuk ke repositori.
- Akurasi dan konsistensi. Cari duplikasi, format yang berbeda, kode yang tidak seragam, serta nilai yang saling bertentangan antarsistem. Contohnya, satu produk dapat memiliki nama berbeda di ERP, katalog, dan dokumen operasional. Samakan definisi atau sediakan pemetaan yang jelas sebelum data digabungkan.
- Kebaruan dan frekuensi pembaruan. Tentukan seberapa cepat informasi perlu diperbarui. Data transaksi harian memiliki kebutuhan berbeda dengan kebijakan internal yang berubah beberapa kali dalam setahun. Dokumen yang sudah digantikan versi baru juga perlu dikenali agar tidak terus muncul sebagai referensi utama.
- Kesiapan data terstruktur dan tidak terstruktur. AI perusahaan sering membutuhkan data tabel sekaligus dokumen seperti SOP, kontrak, manual, notulen, formulir, atau laporan. Periksa apakah dokumen dapat dibaca, memiliki struktur yang masuk akal. Dokumen yang hanya berupa hasil pindai perlu melalui proses ekstraksi sebelum dapat dimanfaatkan.
- Metadata dan konteks bisnis. Nama file atau isi dokumen saja belum tentu menjelaskan unit pemilik, tanggal berlaku, jenis proses, produk, lokasi, atau istilah khusus yang digunakan. Metadata membantu membedakan dokumen yang tampak serupa tetapi berlaku untuk kondisi berbeda.
- Hubungan antarsumber data. Periksa apakah informasi dapat dikaitkan melalui identitas, kode, nomor transaksi, nama pelanggan, produk, atau proses yang sama. Tanpa hubungan tersebut, AI mungkin hanya menemukan potongan informasi, tetapi gagal memahami keterkaitan yang dibutuhkan untuk menjawab pertanyaan lintas sistem.
Hasil pemeriksaan tersebut sebaiknya tidak berhenti sebagai daftar temuan. Perusahaan perlu mengubahnya menjadi penilaian yang menunjukkan sumber mana yang siap digunakan dan mana yang perlu dibenahi.
Cara Menilai Data Tanpa Harus Mengaudit Seluruh Sistem Sekaligus
Langkah pertama adalah menetapkan batas penilaian. Pilih satu use case, satu kelompok pengguna, dan satu proses yang jelas. Misalnya, tim operasional membutuhkan asisten untuk menemukan prosedur penanganan keluhan. Penilaian dapat difokuskan pada SOP, kebijakan layanan, FAQ internal, serta catatan proses yang relevan agar pemeriksaan tetap terarah dan tidak melebar ke seluruh data perusahaan.
Berikutnya, buat inventaris sumber data yang menjawab kebutuhan tersebut. Catat pemilik data, lokasi penyimpanan, format, rentang waktu, frekuensi pembaruan, dan ketergantungan pada sistem lain. Untuk setiap sumber, nilai kelengkapan, konsistensi, kebaruan, serta kemudahan menghubungkannya dengan sumber lain.
Gunakan tiga status sederhana agar hasilnya mudah dibahas lintas fungsi. Status hijau berarti data dapat digunakan untuk pengujian awal. Kuning berarti data tersedia, tetapi memerlukan perbaikan terbatas seperti penyamaan format atau penambahan metadata. Merah berarti informasi inti belum tersedia, tidak konsisten, atau terlalu sulit diverifikasi untuk mendukung use case tersebut.
Penilaian ini bukan sertifikasi atau standar universal. Fungsinya adalah membantu tim bisnis, IT, dan pemilik data menyepakati hambatan yang perlu diselesaikan sebelum PoC. Prioritaskan perbaikan yang memengaruhi jawaban atau keputusan dalam proses yang dipilih.
Setelah prioritas perbaikan diketahui, perusahaan dapat membangun rencana peningkatan data secara bertahap dan menghindari proyek pembersihan besar yang tidak berkaitan langsung dengan kebutuhan bisnis.
Perbaiki Data Berdasarkan Dampaknya terhadap Use Case
Tidak semua masalah data memiliki tingkat urgensi yang sama. Kesalahan pada kode produk yang menjadi dasar pencarian informasi mungkin perlu diperbaiki sebelum pengujian. Sebaliknya, dokumen pendukung yang jarang dipakai dapat dimasukkan pada fase berikutnya jika tidak memengaruhi skenario awal.
Kelompokkan pekerjaan perbaikan menjadi tiga area. Pertama, perbaikan kualitas, seperti menghapus duplikasi, menyamakan format, melengkapi kolom wajib, dan meninjau nilai yang tidak wajar. Kedua, perbaikan struktur, seperti menyusun kategori dokumen, metadata, relasi data, serta penamaan yang konsisten. Ketiga, perbaikan proses pemeliharaan, seperti menetapkan pemilik konten dan jadwal pembaruan.
Untuk dokumen internal, pastikan ada mekanisme yang jelas dalam memperbarui versi. Ketika SOP baru diterbitkan, pengguna perlu dapat membedakan versi berlaku dari versi sebelumnya. Hal yang sama berlaku pada katalog produk, panduan layanan, dan dokumen prosedur. Tanpa disiplin pembaruan, asisten AI dapat menemukan dokumen lama yang secara format terlihat relevan.
Pendekatan bertahap ini sejalan dengan panduan praktis menyiapkan data enterprise untuk AI: fokus pada aset terstruktur maupun tidak terstruktur yang diperlukan use case, bukan menunggu seluruh data perusahaan menjadi sempurna.
Data yang telah dipetakan dan diperbaiki kemudian perlu ditempatkan pada arsitektur yang memudahkan aplikasi AI menggunakannya secara konsisten.
Menghubungkan Kesiapan Data dengan Fondasi AI Perusahaan
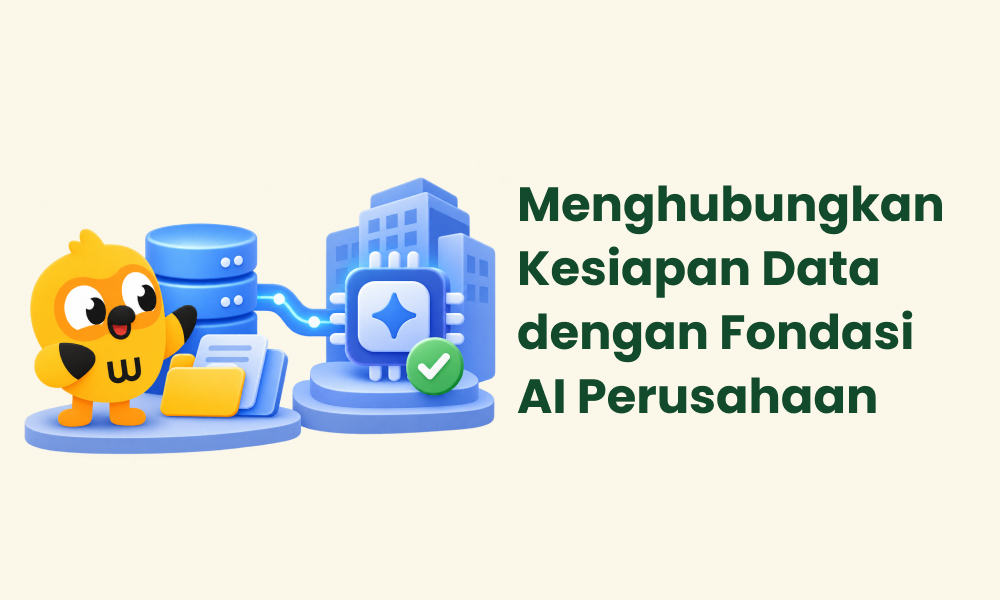
Ketika beberapa use case mulai menggunakan sumber data yang sama, perusahaan perlu memikirkan cara menyiapkan fondasi yang dapat digunakan kembali. Tanpa pendekatan tersebut, setiap proyek berisiko membuat jalur pengambilan data dan proses persiapan yang terpisah. Akibatnya, pemeliharaan menjadi lebih rumit ketika sistem, dokumen, atau kebutuhan bisnis berubah.
Dalam arsitektur Weefer AI, Data Foundation menjadi lapisan yang menyiapkan data perusahaan untuk digunakan oleh aplikasi AI. Halaman resmi Weefer AI menjelaskan peran Data Foundation yang menggabungkan data warehouse, retrieval layer, dan MCP server. Untuk artikel ini, relevansinya terletak pada bagaimana data yang telah diidentifikasi dan disiapkan dapat menjadi sumber bagi aplikasi AI yang dibangun di atasnya.
Fondasi data tetap perlu disesuaikan dengan tujuan, kualitas sumber, dan ruang lingkup implementasi. Perusahaan perlu menguji apakah informasi yang diambil sesuai dengan pertanyaan pengguna dan apakah konteks yang dibutuhkan tersedia. Dengan demikian, kesiapan data dapat dievaluasi secara nyata melalui skenario kerja, bukan hanya berdasarkan dokumen arsitektur.
Pada akhirnya, keputusan untuk melanjutkan AI sebaiknya didasarkan pada bukti bahwa data untuk use case prioritas sudah cukup siap, serta memiliki rencana perbaikan yang realistis.
Kesimpulan: Mulai dari Data yang Paling Dibutuhkan
Kesiapan data untuk AI tidak diukur dari seberapa besar data warehouse atau berapa banyak dokumen yang dimiliki perusahaan. Ukurannya adalah apakah data yang relevan tersedia, cukup lengkap, konsisten, mutakhir, memiliki konteks, dan dapat dihubungkan untuk mendukung proses yang ingin diperbaiki.
Bagi CIO, CTO, CDO, dan pemilik proses bisnis, langkah paling realistis adalah memilih satu use case, memeriksa tujuh aspek di atas, lalu menyusun prioritas perbaikan berdasarkan pengaruhnya terhadap hasil. Perusahaan dapat membangun kesiapan secara bertahap tanpa menunda seluruh inisiatif AI sampai semua data dianggap sempurna. Jadwalkan AI Data Readiness & Security Assessment Gratis
FAQ
Kesiapan data untuk AI adalah kondisi ketika sumber informasi yang dibutuhkan suatu use case tersedia, cukup lengkap, akurat, konsisten, mutakhir, dan memiliki konteks yang dapat dipahami sistem AI.
Tidak. Mulailah dari data yang diperlukan untuk use case prioritas. Perbaikan dapat dilakukan bertahap berdasarkan pengaruh masalah data terhadap kualitas hasil.
Data terstruktur biasanya tersimpan dalam tabel dengan kolom dan format tertentu. Data tidak terstruktur mencakup dokumen, teks bebas, gambar, atau materi lain yang tidak tersusun dalam tabel standar. Banyak use case AI membutuhkan keduanya.
Metadata memberi konteks seperti pemilik dokumen, tanggal berlaku, unit bisnis, kategori proses, dan versi. Informasi ini membantu membedakan sumber yang serupa dan memilih konteks yang tepat.
Pilih satu use case, daftar sumber data yang dibutuhkan, lalu periksa kelengkapan, kualitas, pembaruan, format, metadata, dan hubungan antarsumber. Hasilnya digunakan untuk menyusun rencana perbaikan.









 Batam
